Project · 01 / 04
四足轮腿强化学习(仿真)
参考 robot_lab 重写训练工程,用奖励与课程设计实现 24cm 连续五级台阶攀爬。
- 时间
- 2026.07–2026.09
- 单位
- 重庆机器人企业 · 算法实习
- 阶段
- 仿真训练与策略交付
- 我的角色
- 负责训练工程重写、奖励与课程设计、PPO 训练迭代与策略交付
24cm连续五级台阶攀爬测试条件仿真;台阶高 24cm、宽 30cm、连续五级,超过原定 15cm 目标。这是达成描述,没有对应的成功率统计
44.1%→25.3%速度 >0.5m/s 的时间占比测试条件15cm 台阶、512 环境、摩擦 0.75 的三档训练对照;三组出坑均为 512/512
1.00→0.26m空翻后退漂移测试条件v2 阶段同条件 64 环境回放;同期 yaw 指标变差
64/64高台每档同时到达台面并接触支撑测试条件固定协议仿真;10–100cm 共 10 档、每档 64 环境;12 秒、前进指令 1m/s、摩擦 0.75、无噪声、固定 seed
A
结构一览
- 训练工程参考 robot_lab 重写
- 资产与观测机器人资产 · 观测动作配置
- 奖励与课程可达范围 · 姿态成本 · 渐进课程
- PPO 迭代mjlab · 多任务训练
- 回放与评估动作回放 + 分档评估
- 策略交付模型 + 运行配置 · 分任务入口
动作奖励诱发原地刷分 → 删除非目标行为收益,重审接触与姿态约束
B
我做了什么
- 训练工程:初期在导师代码上开展实验,之后参考 robot_lab 重写训练工程,调整机器人资产、观测动作和奖励配置。
- 奖励修正:发现动作奖励诱发抬落循环、原地踏步刷分,删除非目标行为收益,并重新审视接触与姿态约束。
- 爬楼控制:结合关节可达范围与姿态成本设计奖励和课程,在仿真中实现 24cm 连续五级台阶攀爬,超过原定 15cm 目标。
- 速度约束:引入超速惩罚并做三档训练对照,把训练时的超速惩罚与回放时的限速分开处理。
- 空翻控制:迭代指令触发与起跳速度约束,减小起跳后的后退漂移,完成对应策略交付。
- 起身与高台:为起身设计渐进课程,起身策略通过四种初始倾角验证;为高台设计阶段奖励,并按 10–100cm 分档评估。
- 评估审查:用动作回放核对自动评估。较早一批爬楼评估曾报告 499/500,回放中发现侧身爬楼等异常,确认判据失效后将其作废。
C
结果
在仿真中实现 24cm 高、30cm 宽的连续五级台阶攀爬,超过原定 15cm 目标。
速度约束对照在 15cm 台阶、512 环境、摩擦 0.75 条件下进行:速度 >0.5m/s 的时间占比由 44.1% 降至 25.3%,三组出坑仍为 512/512。
空翻 v2 阶段在同条件 64 环境回放中,后退漂移由 1.00m 降至 0.26m。高台 10–100cm 分档评估中,每档 64/64 同时满足到达台面与接触支撑条件。
交付时统一模型、机器人资产、观测动作与运行配置,在独立目录验证模型加载与推理输出,并提供分任务启动入口。
D
演示记录
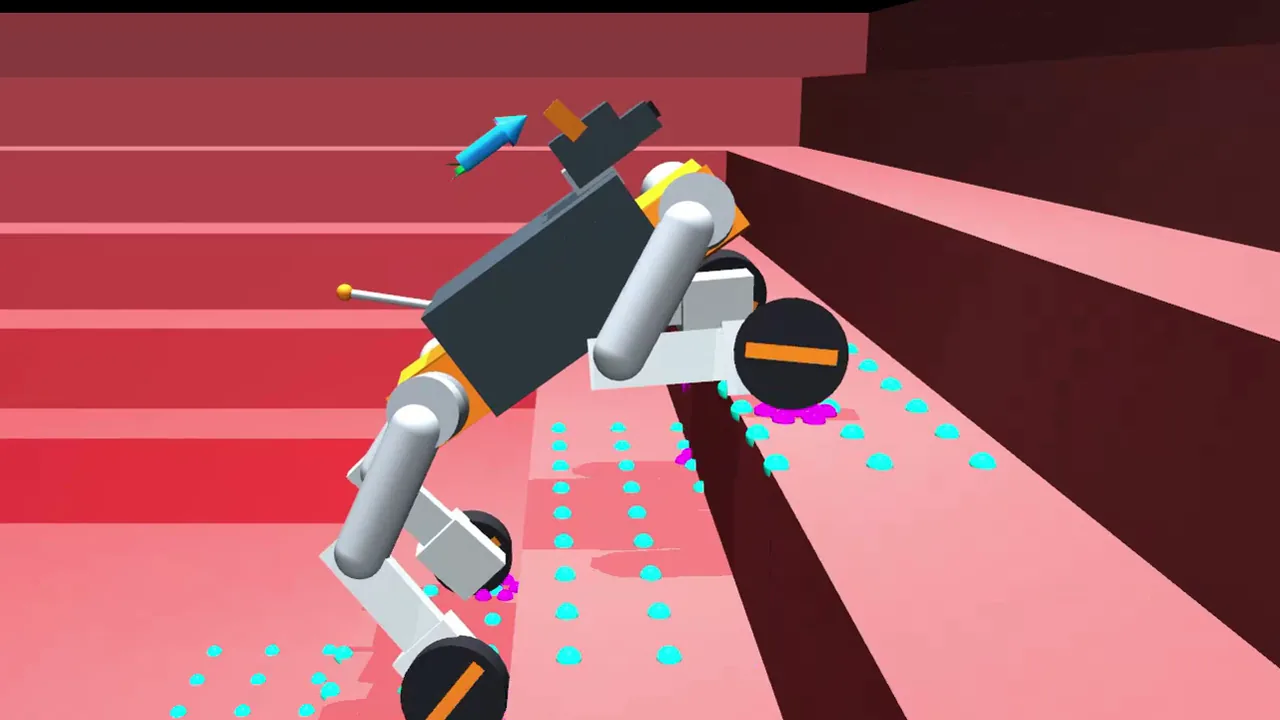
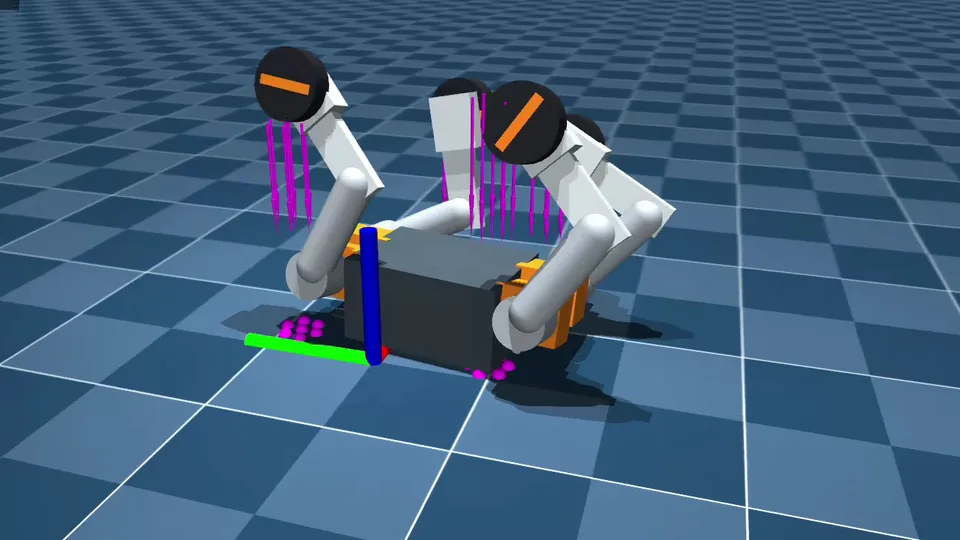
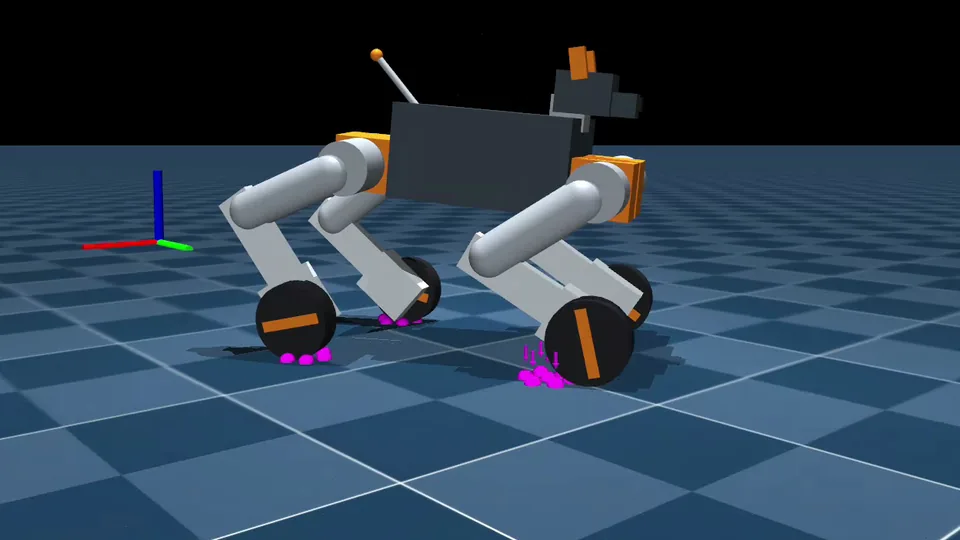
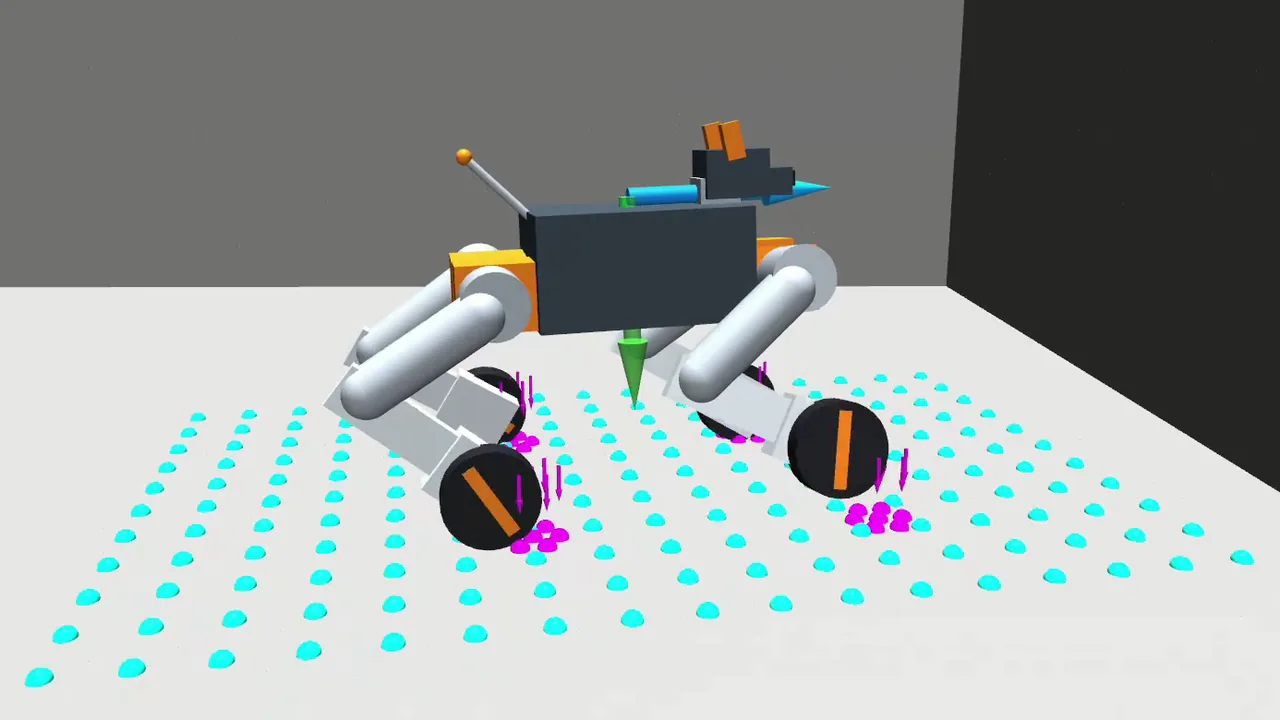
演示视频来自训练过程中的不同阶段,与上方评测不对应同一模型版本。
!
已知局限
- 以上结果均来自仿真,尚未完成真机闭环。
- 24cm 五级是达成描述,没有成功率统计;15cm 的 512 环境对照和 64 环境空翻回放各有条件,不能互相套用。
- 高台判据是到达台面且接触支撑,不代表长时间稳定站台或任意扰动下都能成功。
- 空翻 v2 的后退漂移下降时 yaw 变差;最终交付的 v3 改用了另一套资产与 PD 配置,不与 v2 合并成一个结果。
- 演示视频来自训练过程中的不同阶段,不对应上面某一个具体评测。